Signal Processing & ML · 2025
Reconnaissance de locuteur sur canal radio dégradé
- Contexte
- Projet personnel — traitement du signal
- Année
- 2025
- Technologies
- librosa · SciPy · scikit-learn (SVM) · MFCC
01
Le défi
Identifier un locuteur dans des communications radio de police, où le canal coupe les fréquences, ajoute du bruit et compresse la dynamique.
02
La solution
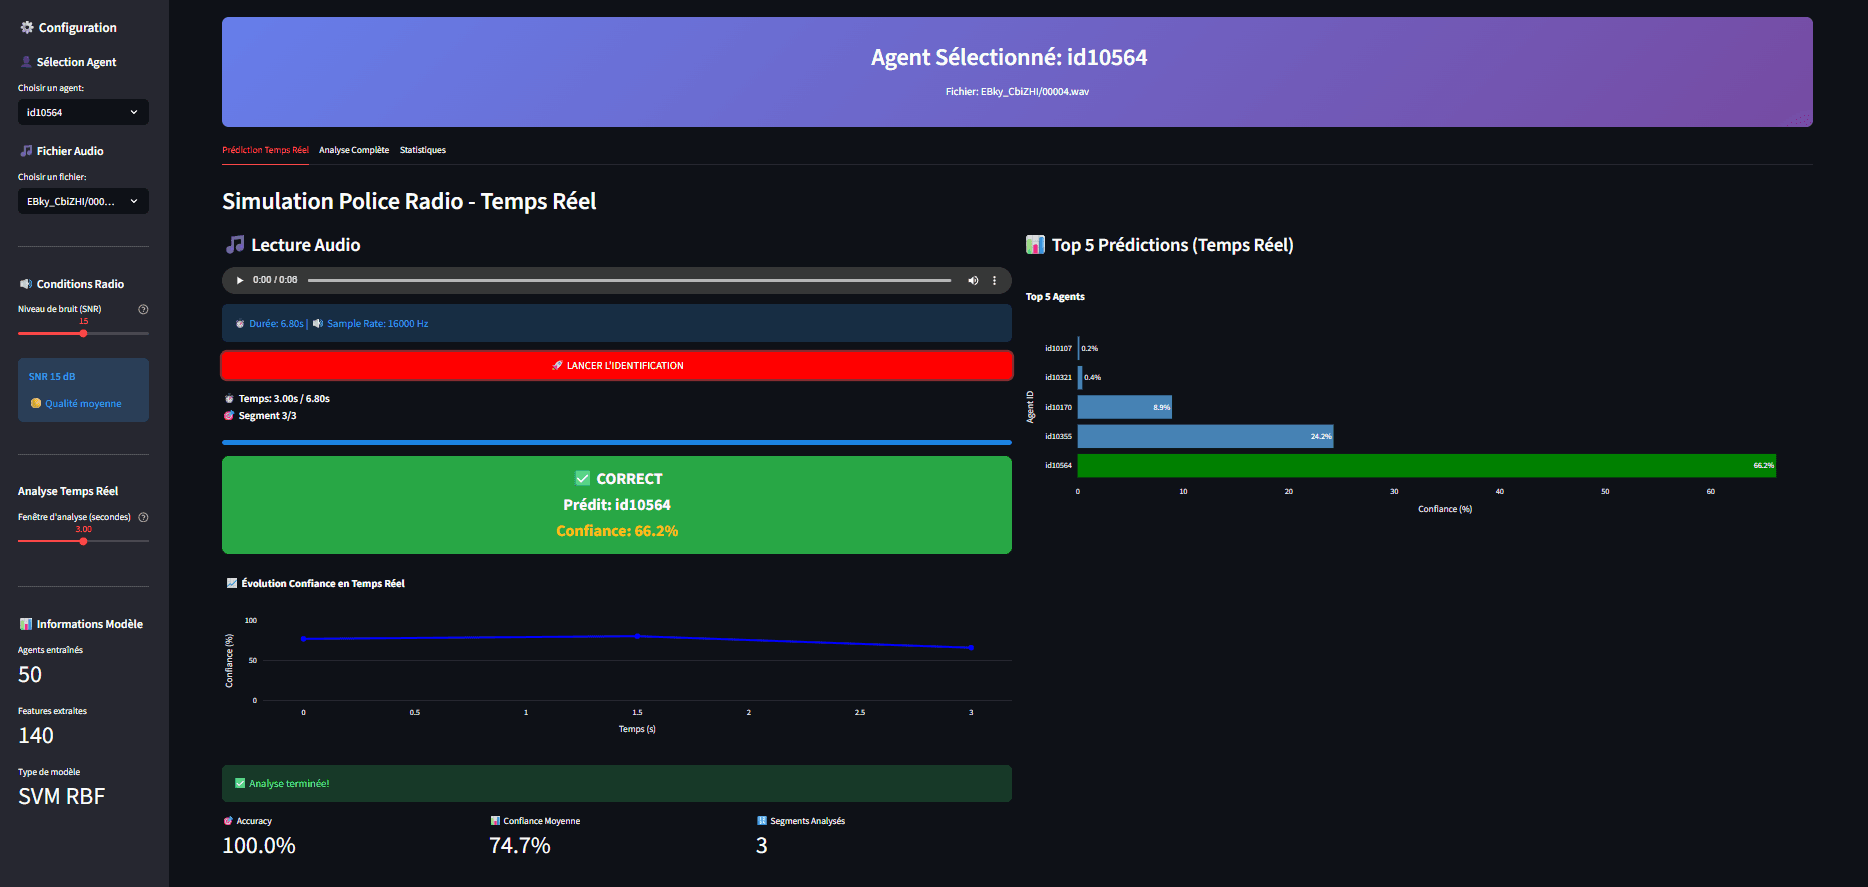
Un pipeline qui simule un canal radio P25 sur des voix VoxCeleb, augmente les données par niveaux de SNR, extrait des features acoustiques robustes et entraîne un SVM, avec une interface Streamlit de démonstration.
03
Architecture
VoxCeleb
50 locuteurs (« agents »)
Simulation canal P25
passe-bande · bruit (SNR) · compression
Features
MFCC, deltas, contraste spectral, ZCR
SVM (noyau RBF)
grid search
Interface Streamlit
04
Implémentation
01Construction du dataset[selection_agents.py, dataset_construction.py]
Sélection de 50 agents, plusieurs versions de chaque enregistrement à différents SNR.
02Entraînement[train_model*.py]
Découpage 70/15/15 stratifié par agent, SVM RBF, recherche d’hyperparamètres, rapport par agent.
05
Résultats
- accuracy de test
- 86.98 %
- accuracy de test
- 2 250 échantillons, 50 agents ; validation 86,89 %, entraînement 92,15 %[Documentation/rapport (OCR)]
L'augmentation par SNR est faite avant un découpage aléatoire non groupé : des versions bruitées d'un même enregistrement peuvent se trouver à la fois en entraînement et en test. Ce score est donc probablement optimiste.
06
Limites
- Fuite possible entre entraînement et test (voir ci-dessus) ; un découpage par enregistrement ou par vidéo serait plus fiable.
- Canal radio simulé, pas d’enregistrements radio réels.