IA Générative & RAG · 2026
Stratégies RAG : chunking, retrieval et ranking
Comparer, étape par étape, les stratégies de chunking, de retrieval et de classement d'un pipeline RAG.
- Contexte
- Projet d'apprentissage — implémentations pas à pas
- Année
- 2026
- Technologies
- LangChain · Azure OpenAI · ChromaDB · Unstructured
01
Le défi
Un pipeline RAG enchaîne des choix — découpage, recherche, classement — dont l'effet est difficile à percevoir sans les implémenter un par un.
02
La solution
Onze scripts et un notebook construisent un RAG sur Azure OpenAI et ChromaDB, puis remplacent une brique à la fois pour comparer les stratégies sur un même petit corpus (cinq fiches d'entreprises et l'article « Attention Is All You Need »).
03
Architecture
Documents
5 fichiers texte + 1 PDF
Découpage
caractères · sémantique · agentique (LLM)
Embeddings Azure OpenAI → ChromaDB
Recherche
similarité · seuil de score · MMR · multi-query
Fusion RRF (k = 60)
Génération
réponse fondée sur le contexte · prise en compte de l'historique
04
Étapes implémentées
01Ingestion et recherche[1–2_*.py]
Chargement, découpage, embeddings Azure OpenAI, persistance ChromaDB ; recherche top-k (k = 5).
02Génération[3–4_*.py]
Réponse contrainte au contexte retrouvé, puis version tenant compte de l'historique de conversation.
03Trois découpages[5–7_*.py]
Par caractères (taille fixe), sémantique (ruptures de sens), agentique (le LLM décide des frontières).
04Recherche avancée[9–11_*.py]
Seuil de similarité, MMR pour la diversité, multi-query (reformulations par le LLM) et Reciprocal Rank Fusion.
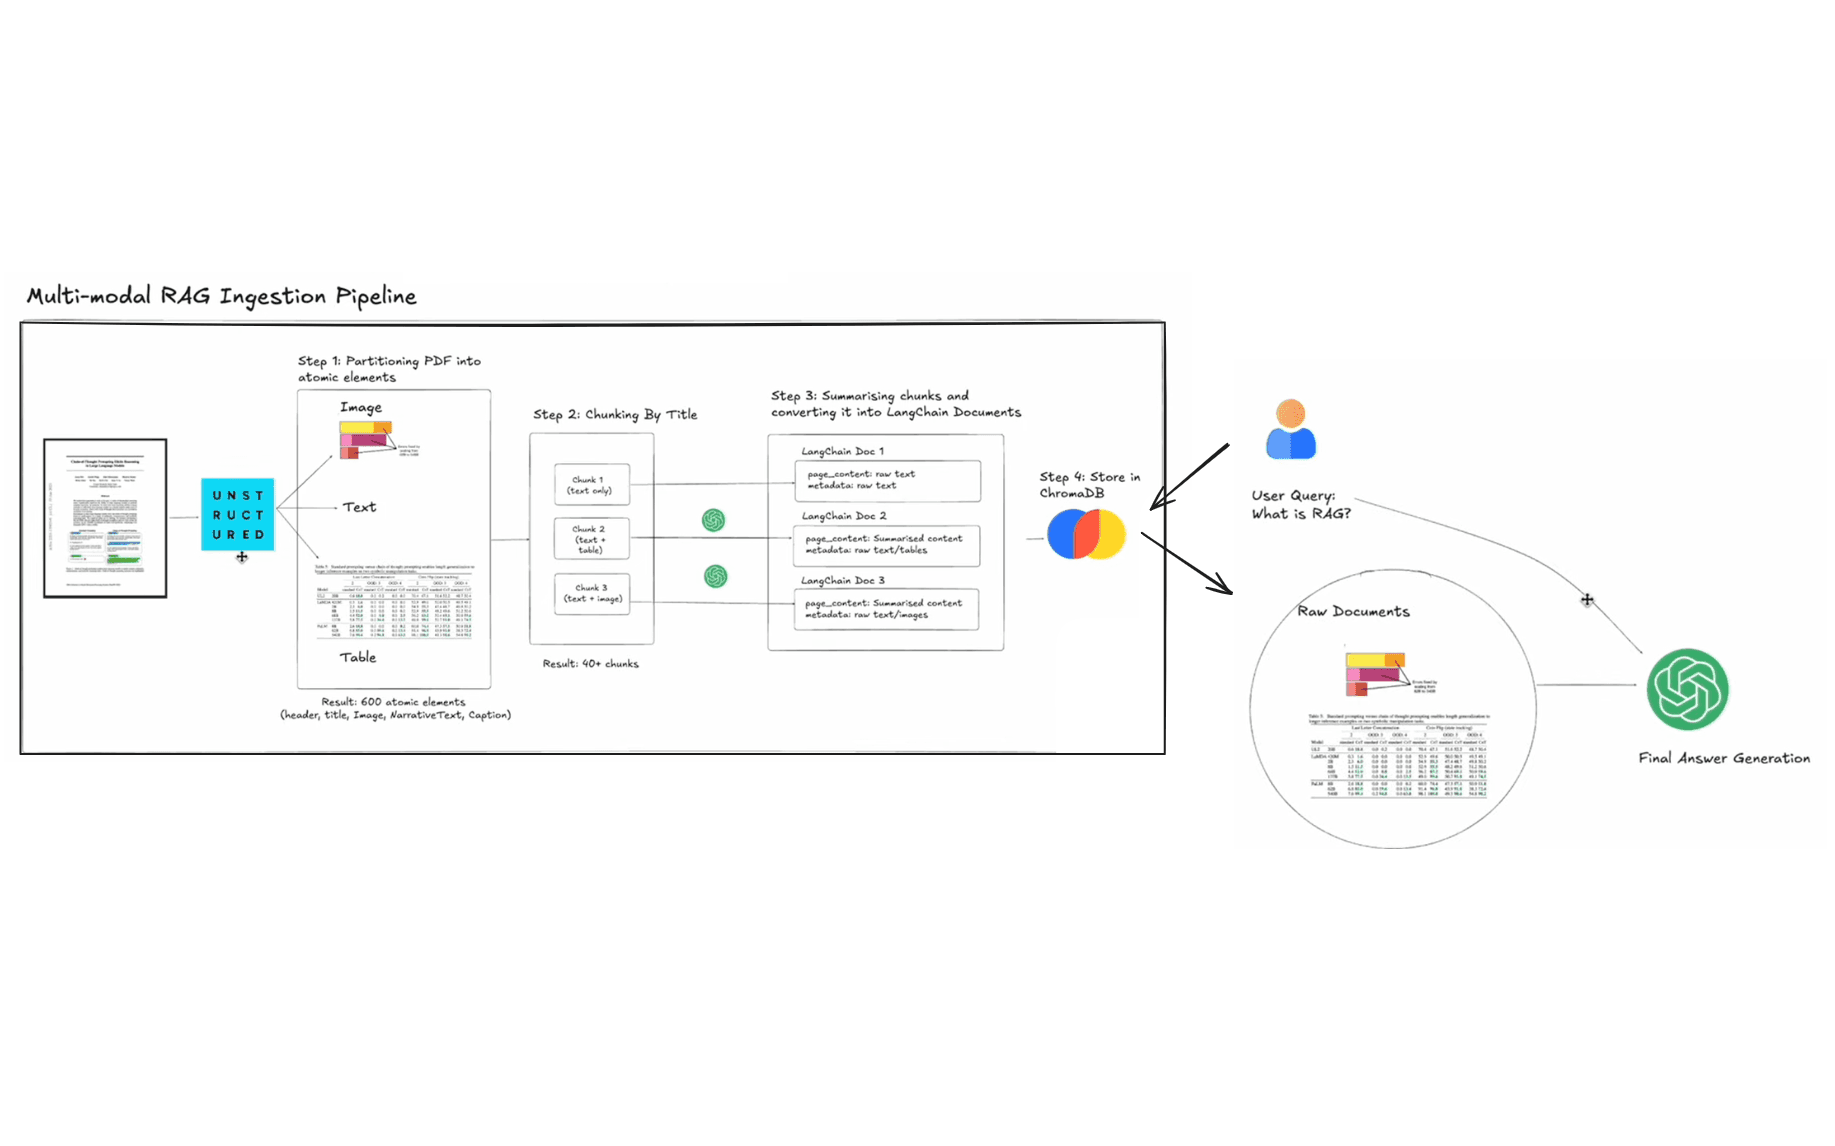
05RAG multimodal[8_multi_modal_rag.ipynb]
Extraction de texte, tableaux et images de PDF (Unstructured, Google Cloud Vision) et chunks enrichis.
05
Limites
- Comparaison qualitative : aucun jeu d'évaluation ni métrique de retrieval (précision@k, fidélité) n'est versionné.
- Corpus très petit ; scripts pédagogiques indépendants plutôt qu’une application.
06
Suites possibles
- Mesurer chaque stratégie sur les questions synthétiques déjà rédigées (synthetic_questions.txt).