Deep Learning · 2026
Deep Learning : du perceptron à la distillation
- Contexte
- Série de projets académiques
- Année
- 2026
- Technologies
- PyTorch · TensorFlow / Keras · YOLOv8 · scikit-learn
01
Le défi
Comprendre le deep learning de l'intérieur, du perceptron aux techniques de compression, en mesurant à chaque étape ce qui marche et ce qui ne marche pas.
02
La solution
Cinq projets progressifs : MLP sur données tabulaires, convolutions codées à la main en NumPy, triage de radiographies (classification et détection), puis distillation de connaissances vers des modèles embarquables.
03
Les cinq projets
01MLP — maladie cardiaque[Heart_Disease_MLP]
Gestion des valeurs manquantes (1 759), MLP 21 → 32 → 16 → 2 (1 266 paramètres) comparé à un modèle linéaire et à un réseau plus profond.
02MLP — trois problèmes supervisés[MLP_Supervised_Learning]
Régression énergétique, classification multiclasse et détection de fraude.
03Convolutions from scratch[Convolutions_From_Scratch]
Convolutions 1D, 2D et 3D en NumPy sur un ECG, une radio et une IRM (filtres de Sobel, coupes).
04Triage de radiographies[Medical_Image_Triage]
CNN et VGG16 gelé pour la pneumonie ; IoU et NMS codés et testés ; comparaison de vitesse de détecteurs COCO.
05Distillation[Knowledge_Distillation]
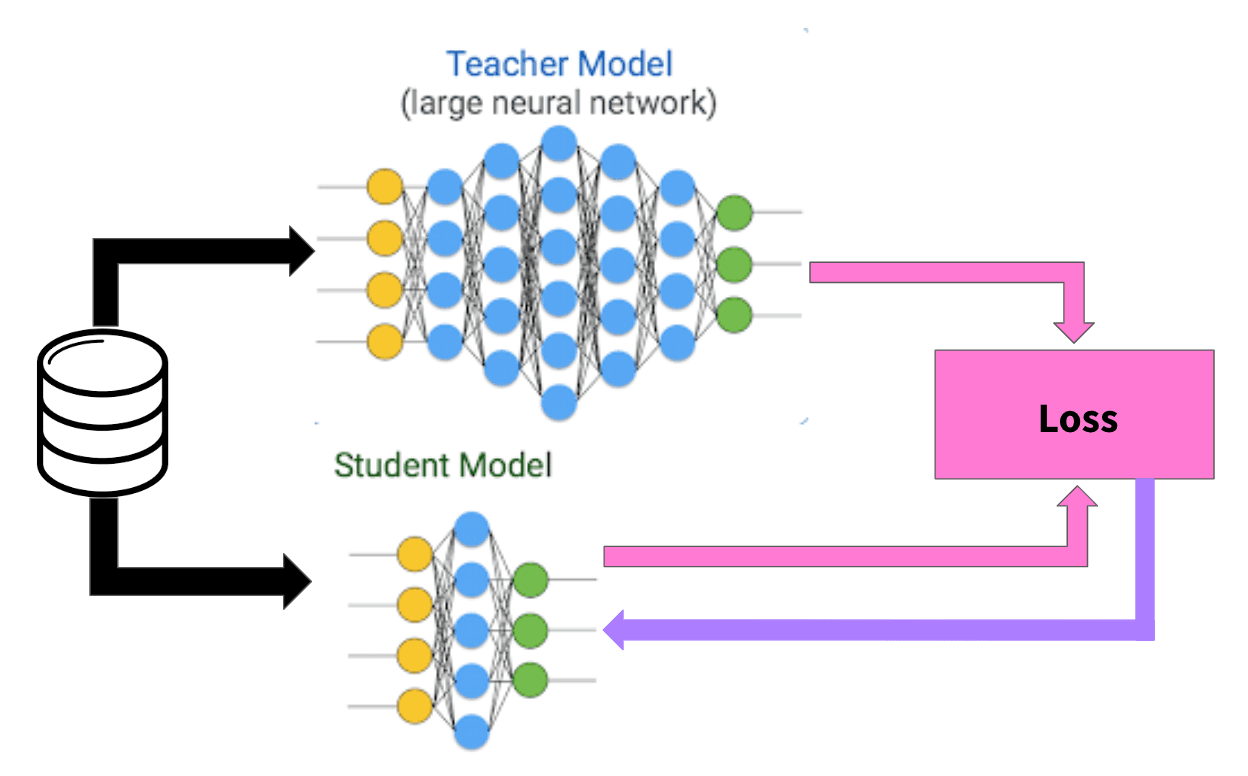
KD, Attention Transfer, FitNets et RKD sur MNIST (élève de 7 539 paramètres) et CIFAR-10.
04
Résultats
- accuracy — maladie cardiaque
- 84.8 %
- accuracy — maladie cardiaque
- 184 patients de test ; rappel 0,91 sur les malades ; linéaire : 72,8 %[Heart_Disease_MLP/README.md]
- ROC-AUC — fraude bancaire
- 0.903
- ROC-AUC — fraude bancaire
- rappel 84,5 %, précision 60,2 % sur la classe à risque[Bank_Fraud_Detection/README.md]
- accuracy — pneumonie
- 93.2–93.3 %
- accuracy — pneumonie
- CNN de base et VGG16 gelé[Medical_Image_Triage/README.md]
- YOLOv8n vs Faster R-CNN
- 243 vs 5 881 ms
- YOLOv8n vs Faster R-CNN
- vitesse seule, CPU, 20 radios, détecteurs COCO sans sens clinique[Medical_Image_Triage/README.md]
Les échecs sont documentés : le modèle multiclasse ne dépasse pas le hasard (3,2 % contre 3,3 %), et sur CIFAR-10 l’élève seul (81,8 %) fait mieux que l’élève distillé (76,5 %).
05
Limites
- Triage partiel : fine-tuning de VGG16/ResNet50 et entraînement complet du U-Net non menés à terme.
- Enseignant MNIST mal entraîné (33,96 %) : l’apport de la distillation n’y est pas démontrable.