IA Agentique & RAG · 2026
cvmatch — Adapter son CV à une offre, compétence par compétence
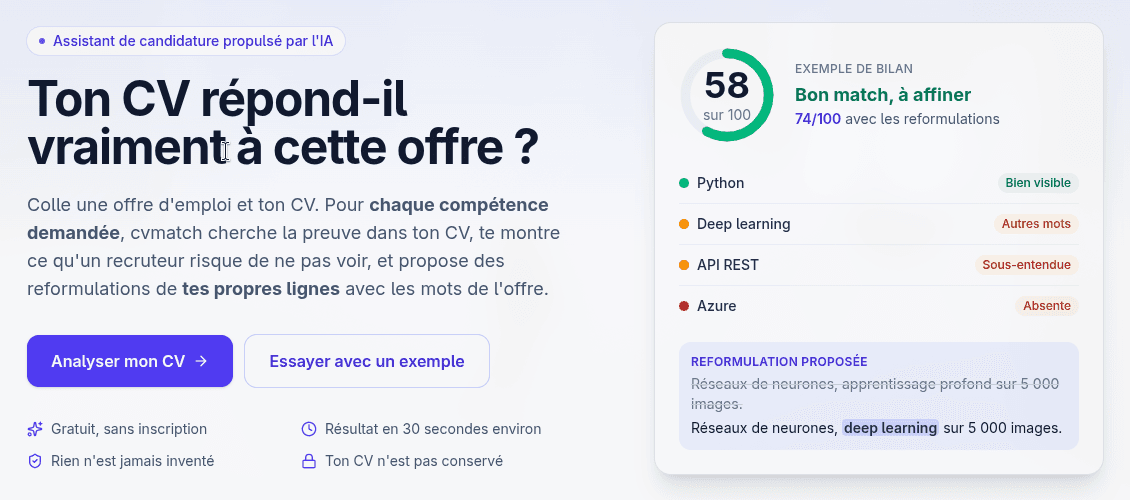
Adapter un CV à une offre sans jamais inventer d'expérience : chaque compétence demandée doit s'appuyer sur une preuve dans le CV.
- Contexte
- Projet personnel — démo en ligne
- Année
- 2026
- Technologies
- LangGraph · Hybrid RAG (BM25 + embeddings) · Azure OpenAI · Pydantic
01
Le défi
Une offre liste des exigences, un CV contient des preuves — souvent formulées avec d'autres mots. Les ATS et les recruteurs pressés cherchent les termes exacts de l'offre.
Un LLM seul peut inventer une preuve, se tromper de statut ou halluciner un chiffre : il faut un système qui aide à reformuler sans jamais inventer d'expérience.
02
La solution
Pour chaque compétence de l'offre, cvmatch retrouve la preuve dans le CV, la classe en quatre statuts (visible, cachée, implicite, absente), calcule un score en code et propose des reformulations des propres lignes du candidat. Principe central : le LLM propose, le code vérifie.
03
Architecture
Offre d'emploi
CV (pdf / md / txt)
parse_offer ⟲ verify_exhaustivity
relance si des compétences manquent
index_cv
chunks · BM25 + embeddings optionnels
Send : une branche par compétence
retrieve (top-4, RRF) → judge ⟲ verify (3 essais max)
aggregate → summarize
score calculé en code
human_review (interrupt)
finalize → bilan
04
Implémentation
01Garde-fous déterministes[verification.py]
Une citation doit exister mot pour mot dans le CV ; « visible » vs « cachée » est tranché par le code ; un verdict « absent » est rejeté si le terme figure dans les extraits ; une reformulation ne peut ajouter ni chiffre ni outil.
02RAG hybride[retrieval.py, config.py]
Pour chaque compétence, 4 extraits retrouvés par BM25 (+ embeddings si configurés), fusion RRF, requête enrichie de synonymes FR/EN et de déclencheurs implicites.
03Sorties structurées[schemas.py]
Chaque réponse LLM est validée par un schéma Pydantic.
04API et site[api.py, limits.py]
FastAPI avec streaming SSE, site Next.js, CLI ; garde-fous d’usage (taille d’entrée, PDF ≤ 5 pages, quotas par heure et par jour, CORS, clé API optionnelle).
05CI[.github/workflows/ci.yml]
GitHub Actions : pytest sur Python 3.10 et 3.12 avec un LLM factice, build du site, build de l’image Docker.
05
Décisions techniques
Score calculé en code
Jamais par le LLM : reproductible, auditable, testable.
Le juge ne voit que les extraits
Limiter le contexte aux extraits retrouvés réduit les inventions ; un « absent » est malgré tout revérifié sur tout le CV.
LLM factice pour les tests
Toute la plomberie (RAG, boucles, score) est testée hors ligne, sans clé ni coût.
06
Résultats
- tests collectés — 124 réussis, 1 ignoré
- 125
- tests collectés — 124 réussis, 1 ignoré
- exécutés le 19/10/2026 hors ligne (LLM factice), en 12,9 s[pytest]
Aucune métrique de qualité n'est publiée : le README indique que le système n'a pas encore été évalué avec un vrai LLM. Le protocole d'évaluation (cas synthétiques, baselines TF-IDF et « un seul prompt ») est implémenté mais ses résultats ne sont pas versionnés.
07
Limites
- Jamais évalué contre un vrai LLM ni de vrais embeddings (README).
- Le statut « implicite » reste subjectif : la validation humaine est là pour ça.
- Référentiel d’environ 60 compétences IA/data/MLOps ; compteurs de débit en mémoire (une seule instance).
- Les PDF à deux colonnes peuvent être extraits dans le désordre.
08
Suites possibles
- Lancer l’évaluation avec un vrai fournisseur et publier les résultats.
- Checkpointer SQLite/Postgres pour reprendre une validation interrompue ; traces LangSmith.