NLP & Fine-tuning · 2026
Détection de désinformation médicale en arabe
Détecter la désinformation médicale dans des tweets arabes (corpus ArCOV19-Rumors).
- Contexte
- Projet personnel — NLP
- Année
- 2026
- Technologies
- AraBERT · Hugging Face Transformers · PyTorch · Accelerate
01
Le défi
Repérer la désinformation médicale dans des tweets arabes (corpus ArCOV19-Rumors), une langue où les outils sont moins nombreux et le texte très bruité (dialectes, diacritiques, emojis).
02
La solution
Fine-tuning d'AraBERT (bert-base-arabertv02) avec normalisation arabe, découpage stratifié, déduplication et seuil de décision réglé, comparé à une baseline TF-IDF.
03
Architecture
ArCOV19-Rumors
tweet_verification · 3 584 tweets
Normalisation arabe
diacritiques, URL, mentions, emojis, variantes de caractères
Déduplication
617 doublons retirés → 2 967
Fine-tuning AraBERTv02
5 époques · lr 2e-5 · max 128 tokens
Baseline TF-IDF
Seuil 0,70 · analyse d’erreurs
04
Implémentation
01Entraînement robuste[train.py, final_report.txt]
Découpage stratifié train/validation/test (2 373 / 297 / 297), graine 42, réessai automatique avec un batch plus petit en cas de mémoire GPU insuffisante.
02Améliorations mesurées[src/improve_*.py]
Scripts dédiés : déduplication, optimisation du seuil, analyse d’erreurs, exécutions multi-graines, baseline TF-IDF.
05
Résultats
- accuracy
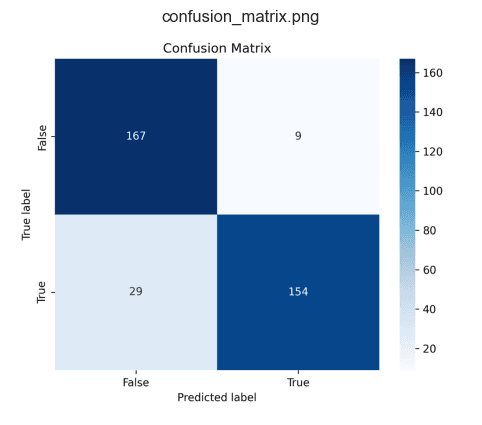
- 0.869
- accuracy
- modèle final, 297 tweets de test, après déduplication, seuil 0,70[final_report.txt]
- F1 macro
- 0.869
- F1 macro
- même jeu de test[final_report.txt]
| Modèle | Accuracy | F1 macro |
|---|---|---|
| AraBERTv02 (seuil 0.50) | 0.894 | 0.894 |
| TF-IDF baseline | 0.908 | 0.908 |
Sur ce jeu de données, la baseline TF-IDF fait légèrement mieux qu'AraBERT avant déduplication. Après déduplication (moins de fuites entre doublons), AraBERT descend à 0,869 ; la baseline n'a pas été réévaluée sur ce nouveau jeu de test.
06
Limites
- Petit jeu de données (2 967 tweets) : un seul découpage de test publié.
- Le gain d’AraBERT sur une baseline lexicale n’est pas démontré ici.
07
Suites possibles
- Réévaluer la baseline sur le jeu dédupliqué ; agréger les exécutions multi-graines.